
LONDON (IT BOLTWISE) – Modder haben für GeForce RTX 30- und RTX 40-Karten eine Firmware-Umgehung entwickelt, die die Instruction-Issuing-Rate deutlich erhöht. Für ausgewählte GA102/GA103/GA104/GA106-Modelle werden laut Demonstration bis zu etwa 2x schnellere FP32-Matrixoperationen aus FP/BF16-FMA abgeleitet. Bei der GeForce RTX 4090 steigt der gemessene Tensor-Throughput von 165,6 TeraFLOPS auf 331,6 TeraFLOPS, während Stock-Treiber und CUDA-Benchmarks weiterhin normal laufen. Gleichzeitig wird die Änderung beim Boot aktiviert und macht die Herstellergarantie ungültig.
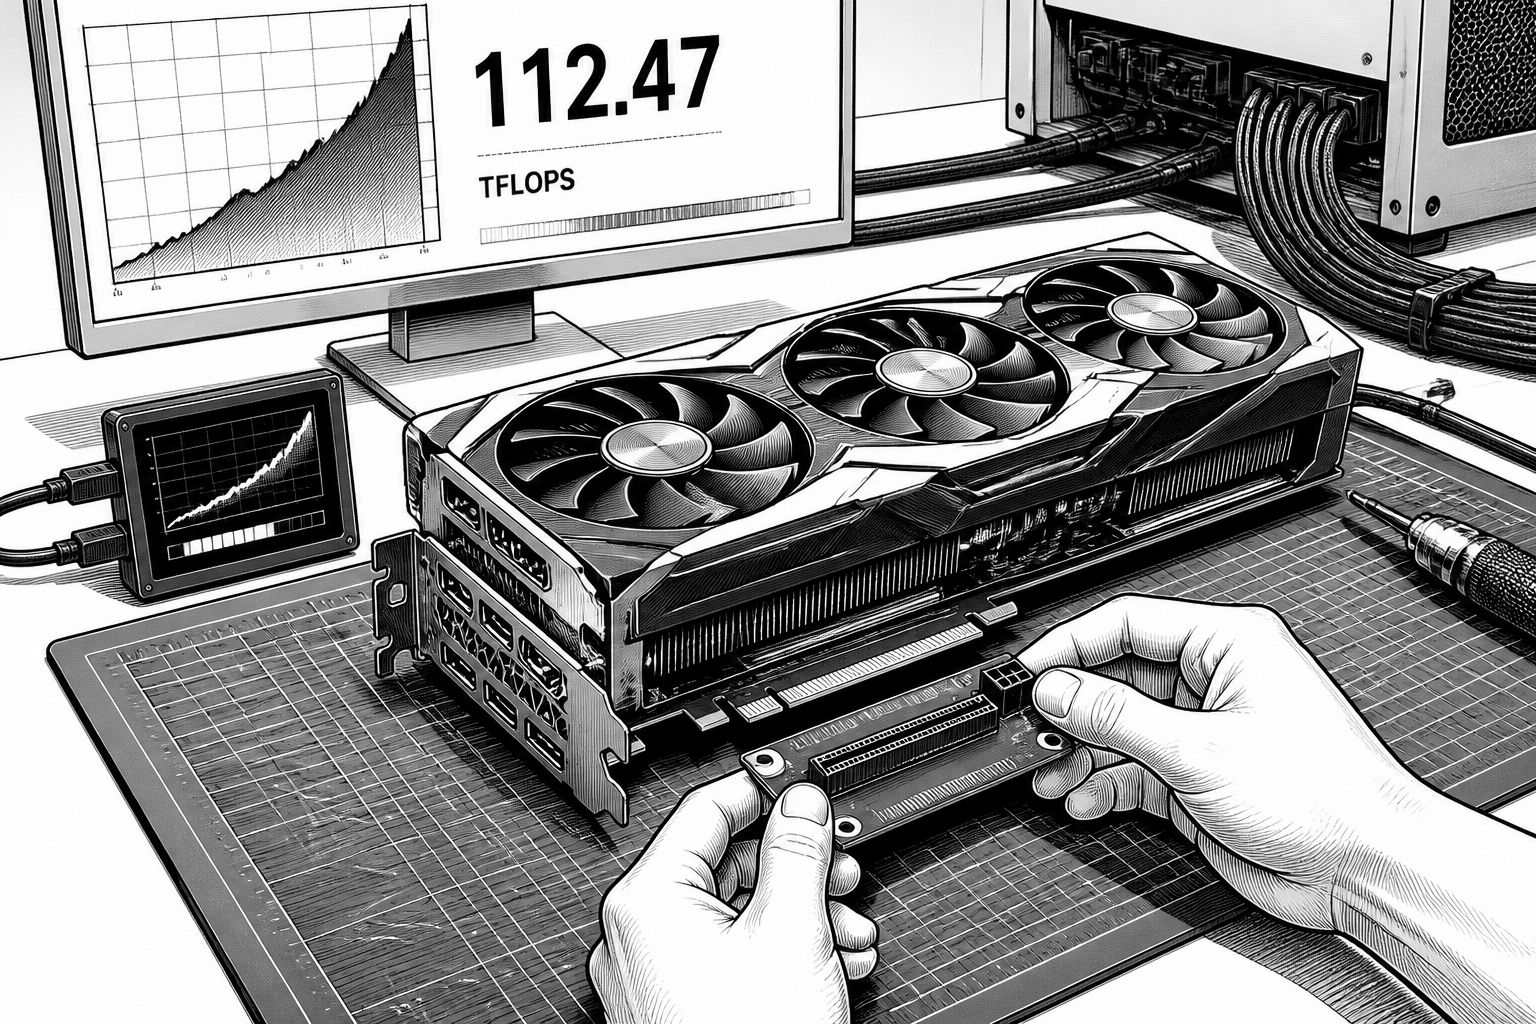
Für Käufer von GeForce RTX 30 und RTX 40 war die Segmentierung zwischen Consumer- und Profi-Linie lange ein stilles Prinzip: NVIDIA nutzt bei beiden Klassen ähnliche GPU-Dies, limitiert aber offenbar in firmware- und driverseitigen Pfaden, was in compute-sensiblen Workloads wirklich herauszuholen ist. Genau hier setzen aktuelle Mod-Ansätze an. Laut der vorliegenden Beschreibung wird der Instruction-Issuing-Rate-Pfad so „entsperrt“, dass Konsumenten-RTXs bei bestimmten Matrix- und Tensor-Operationen näher an das heranreichen, was man bisher eher im höheren professionellen Segment verortete.
Beim GeForce RTX 30-Lineup mit „Ampere“ startet die Methodik auf der Ebene, die für moderne KI-Rechenkerne entscheidend ist: Die FP/BF16-FMA-Implementierung wird so umgeleitet, dass sie in FP32-Operationen resultiert. Der Effekt wird für GA102-, GA103-, GA104- und GA106-basierte Karten gezeigt, darunter explizit die GeForce RTX 3090 Ti. In der Demonstration bedeutet das bis zu 80 % schnellere Matrixmultiplikation in BF16 – ein relevanter Baustein für fast alle typischen Neural-Net-Workloads. Gerade bei großen Modellen zählt dabei weniger das reine Peak-FLOPS-Marketing als die effektive Ausführung der für Training oder Inferenz nötigen Kernoperationen.
Mit der GeForce RTX 40-Reihe, „Ada Lovelace“, geht die Mod-Community einen Schritt weiter und adressiert tensorlastige Pfade noch direkter. Für die GeForce RTX 4090 wird berichtet, dass der Unlock den Tensor-Throughput bei FP16 sowie BF16 mit FP32 accumulation von 165,6 TeraFLOPS auf 331,6 TeraFLOPS hebt. Dass solche Kennzahlen normalerweise dem höherpreisigen Profi-Umfeld vorbehalten sind, wird damit zum zentralen Spannungsfeld: Wenn die Rohleistung „auf dem Die“ vorhanden ist, aber im compute-sensiblen Bereich per Firmware-Stack und Konfiguration künstlich begrenzt wird, entsteht genau dort ein Durchbruch, der in Benchmarks sichtbar wird.
Technisch interessant ist auch, wie die Modifikation in den Systembetrieb eingehakt wird. Die beschriebenen Unlocks sollen NVIDIA-Checks in der Treiberkette passieren und außerdem PCIe Function Level Reset (FLR) überschreiben, sodass Stock-Treiber und CUDA-Benchmarks weiterhin funktionieren. Ebenso werden in der Darstellung konstante Betriebsparameter betont: Die gleiche 450-W-TGP-Board-Power wird vor und nach dem Unlock für GA102 und für AD102 verwendet. Das ist ein Hinweis darauf, dass es sich nicht um „mehr TDP durch mehr Spannung“ handelt, sondern eher um einen Pfad, der die Ausführung bestimmter Instruktionen oder die Zuweisung in Rechenmodi beeinflusst.
Für den praktischen Nutzen – etwa bei lokalem LLM-Einsatz – übersetzt sich die zusätzliche Rechenkapazität in messbar höhere Token-Throughput-Raten. In der Beschreibung wird dabei explizit auf Prefill und Decode abgestellt: In diesen Phasen bestimmt die Kombination aus Matrix-/Tensorrechnen und Datenbewegung, wie schnell das Modell aus dem Prompt kontextualisiert und anschließend die nächsten Tokens generiert. Wenn der Unlock den Engpass bei matrix multiplication und accumulation verschiebt, profitieren in der Praxis vor allem Systeme, die ohne Batch-Overprovisioning auskommen und bei denen Latenz und Durchsatz direkt über die Nutzererfahrung entscheiden.
Wer das nachbauen oder im eigenen Setup einsetzen will, muss allerdings die betrieblichen und rechtlichen Randbedingungen einplanen. Die Änderung erfolgt über eine Modifikation der GPU-Funktionalität und macht laut Quelle die Herstellergarantie ungültig. Außerdem muss sie beim Boot aktiviert werden, damit die Änderungen „binden“, bevor NVIDIA Treiber die Karte an den Kernel koppeln. Das bedeutet für Betreiber auch: Nach jedem größeren Treiber-Update ist ein erneuter Test nötig, denn schon kleine Änderungen an der Initialisierungsreihenfolge oder an Validierungsroutinen können dazu führen, dass ein Unlock plötzlich nicht mehr greift.
Ein weiterer Hinweis aus dem Updatezeitpunkt erhöht die Relevanz über die aktuellen Generationen hinaus: Demnach werden auch GeForce RTX 20-Karten („Turing“) mit derselben Technik entsperrt, wobei die Leistungssteigerung ebenfalls mit einem Faktor von 2x beziffert wird. Für die Branche ist das vor allem ein Signal, dass die Ursache weniger in einzelnen „abgekündigten“ Hardware-Generationen liegt, sondern eher in wiederkehrenden Firmware-/Validierungsmechanismen. Unabhängig davon, wie dauerhaft und breit ein solcher Unlock nutzbar bleibt, zeigt der Ansatz klar, wie viel Spielraum zwischen vorhandenem Silizium und tatsächlich freigegebenen Compute-Pfaden steckt – und warum sich Performance-Optimierung für KI auf der GPU-Ebene nicht nur auf Treiber-Updates beschränkt, sondern zunehmend auch auf die Schnittstelle zwischen Firmware, PCIe-Reset-Verhalten und Ausführungslogik schaut.
🔥 Heutige Hot Deals bei Amazon: Bis zu 80% Rabatte!
🎉 Amazon Haul-Store für absolute Schnäppchenjäger!

- ★ 23-stufiges KI-Go-Training – Für Spieler mit Grundkenntnissen der Regeln – Entwickelt als intelligenter Trainingspartner passt sich die KI Spielern von 18K bis 9D an. Ideal für alle, die die Grundregeln bereits beherrschen und ihr Spiel verbessern möchten.

- IHR EMOTIONALER AI-BEGLEITER: Eiliko ist mehr als nur ein Anhänger, es ist ein charismatischer KI-Freund. Mit einem dynamischen LED-Bildschirm, der eine Vielzahl von animierten Gesichtern und Ausdrucksformen anzeigt, reagiert er auf Ihre Interaktionen mit einzigartiger Persönlichkeit und Charme.

- 【MEHR LEBEN FÜR DEINEN SCHREIBTISCH】 Lerne Eilik kennen – deinen kleinen Roboter-Freund mit Persönlichkeit. Mit liebevollen Animationen, ausdrucksstarken Reaktionen und spielerischen Interaktionen bringt Eilik mehr Freude in deinen Alltag. Ob auf dem Schreibtisch, im Büro oder am Nachttisch – Eilik wird schnell zu einem vertrauten Begleiter für besondere Momente.

- 【XL-Größe für gedeihende Pflanzen】Geben Sie Ihren Pflanzen den Raum, den sie verdienen! Unser verbessertes, großes 13,7 cm großes Design bietet Platz für Pflanzen mit einem Durchmesser von bis zu 8,9 cm und damit deutlich mehr Platz für Wurzelwachstum und Pflanzengesundheit im Vergleich zu kleineren, veralteten Modellen. Die Produktabmessungen betragen 13,6 x 13,6 x 13,2 cm und das Gerät wiegt nur 355 g.

- V28 Update - JETZT MIT NEUEN FUNKTIONEN! Als Reaktion auf das Ladeproblem von Loona haben wir das automatische Aufladen 2.0 verbessert. Diese Optimierung hilft Loona, die Ladewege in verschiedenen Szenarien zu erkennen und anzupassen, um die Erfolgsquote beim automatischen Aufladen zu erhöhen. Mobile Hotspots können sich mit Loona verbinden und überwinden WLAN-Einschränkungen, sodass Sie jederzeit und überall mit Loona interagieren können.





- Die besten Bücher rund um KI & Robotik!

- Die besten KI-News kostenlos per eMail erhalten!
- Zur Startseite von IT BOLTWISE® für aktuelle KI-News!
- IT BOLTWISE® kostenlos auf Patreon unterstützen!
- Aktuelle KI-Jobs auf StepStone finden und bewerben!



- Künstliche Intelligenz: Dem Menschen überlegen – wie KI uns rettet und bedroht | Der Neurowissenschaftler, Psychiater und SPIEGEL-Bestsellerautor von »Digitale Demenz«


Du hast einen wertvollen Beitrag oder Kommentar zum Artikel "GeForce-RTX-Mods verdoppeln Tensor- und Matrix-Throughput bei GA- und AD-GPUs" für unsere Leser?
 #Sophos
 #AmazonPrime
 #Bestseller
Es werden alle Kommentare moderiert!
Für eine offene Diskussion behalten wir uns vor, jeden Kommentar zu löschen, der nicht direkt auf das Thema abzielt oder nur den Zweck hat, Leser oder Autoren herabzuwürdigen.
Wir möchten, dass respektvoll miteinander kommuniziert wird, so als ob die Diskussion mit real anwesenden Personen geführt wird. Dies machen wir für den Großteil unserer Leser, der sachlich und konstruktiv über ein Thema sprechen möchte.
Du willst nichts verpassen?
Du möchtest über ähnliche News und Beiträge wie "GeForce-RTX-Mods verdoppeln Tensor- und Matrix-Throughput bei GA- und AD-GPUs" informiert werden? Neben der E-Mail-Benachrichtigung habt ihr auch die Möglichkeit, den Feed dieses Beitrags zu abonnieren. Wer natürlich alles lesen möchte, der sollte den RSS-Hauptfeed oder IT BOLTWISE® bei Google News wie auch bei Bing News abonnieren.
Nutze die Google-Suchmaschine für eine weitere Themenrecherche: »GeForce-RTX-Mods verdoppeln Tensor- und Matrix-Throughput bei GA- und AD-GPUs« bei Google Deutschland suchen, bei Bing oder Google News!